
PDF를 더 압축하면 작은 글씨가 흐려질 것 같은데, 파일은 아직 업로드 한도를 넘는다면 어떻게 해야 할까요? 받는 곳이 여러 PDF 제출을 허용한다면, 필요한 페이지를 빼는 대신 문서 전체를 용량별로 나눌 수 있습니다. 다만 파일을 나누는 것과 첨부 제한을 실제로 충족하는 것은 구분해야 합니다.
이번에는 설치형 프로그램 대신 Sejda 웹의 크기별 분할을 직접 실행했습니다. 시험에는 이미 공개된 NIST의 48페이지 PDF를 사용했고, 최대 크기를 500KB로 설정한 입력 화면과 ZIP 준비 완료 화면을 촬영했습니다. 현재는 결과 ZIP의 수령과 분할본의 크기·전체 페이지 대조가 끝나지 않았으므로, 모든 페이지가 상한에 맞게 나뉘었다는 완료 사례로 제시하지는 않습니다. 확인 기준일은 2026년 10월 17일입니다.
이 글의 순서
파일별 상한을 맞출 때 Sejda 웹을 써도 될까?
먼저 제출처가 제한하는 것이 파일 하나의 크기인지, 첨부 전체의 합계인지 확인하세요. 여러 파일을 허용하면서 각 파일에만 상한을 두는 곳이라면 용량별 분할을 적용할 수 있습니다. PDF 하나만 받거나 첨부 전체의 합계에 같은 한도를 두는 곳에서는, 파일 수를 늘리는 것만으로 제출 조건을 충족하지 못합니다.
Sejda의 크기별 분할 페이지는 파일과 최대 분할 문서 크기를 지정하는 기능을 제공합니다. 무료 이용 안내는 ‘200페이지 또는 50MB, 시간당 3작업’으로 표시되어 있습니다. 이번 원본은 48페이지·1,946,127바이트이므로 페이지 수와 파일 크기 모두 해당 안내 범위 안에 있습니다. 작업 횟수 제한까지 없어지는 것은 아니므로, 화면에 한도 안내가 나오면 같은 작업을 계속 누르거나 유료 전환을 임의로 진행하지 마세요.
참조: Sejda — 파일 크기별 PDF 분할과 무료 이용 안내
설치가 필요 없는 대신 파일은 Sejda 서버에서 처리됩니다. 기능 페이지는 일반 처리 파일을 비공개로 유지하고 2시간 뒤 자동 삭제한다고 안내하며, 개인정보처리방침에는 SSL 전송과 파일 보관 목적을 설명합니다. 이 안내가 회사의 문서 반출 승인이나 절대적인 보안 보장을 대신하는 것은 아닙니다. 그래서 이번에는 사용자 개인 자료 대신 이미 공개된 공식 문서를 사용했습니다.
참조: Sejda — 파일 처리·보관에 관한 개인정보처리방침
따라서 여러 파일 제출이 가능하고, 문서를 외부 서비스에서 처리해도 되는 경우에 이 방법을 선택하세요. 단일 파일이나 첨부 총합 제한, 외부 반출이 금지된 문서에는 같은 해결책을 그대로 적용하면 안 됩니다.
공개 PDF 주소를 넣고 목표 크기를 어떻게 정할까?
Sejda의 파일 크기별 분할 페이지를 엽니다. 이번에는 업로드 버튼 옆 메뉴에서 웹 주소(URL)를 선택했습니다. ‘파일의 웹 주소를 Paste 하세요:’ 입력창에 NIST 공식 PDF 주소를 넣고 계속을 눌렀고, 설정 화면에 Selected: NIST.AI.100-1.pdf가 표시되는 것을 확인했습니다. 아래 주소는 이미 공개된 문서의 위치이며 개인 계정이나 비공개 공유 링크가 아닙니다.
시험에 사용한 NIST 공식 PDF — AI Risk Management Framework 1.0
파일이 선택되면 가장 큰 분할 문서의 최대 크기에 숫자를 입력하고 MB 또는 KB를 고릅니다. 이번에는 500을 입력한 뒤 KB를 선택했습니다. 페이지 수로 나누기나 필요한 페이지만 추출하기가 아니라, 파일 크기에 따라 나누는 화면인지도 확인하세요. 이 숫자는 이번 시험 설정이며 모든 제출처의 권장값은 아닙니다.
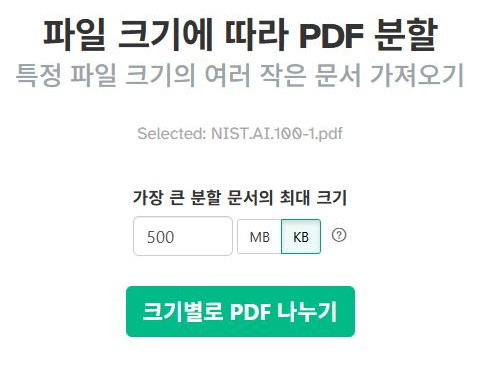
입력 단계에서 확인할 것은 선택한 원본 파일, 숫자, 단위입니다. 500KB를 입력했다는 사실만으로 결과 PDF가 모두 그 크기 이하이고 페이지도 빠지지 않았다고 판단해서는 안 됩니다.
분할 실행 후 결과를 어떻게 받을까?
설정을 확인한 뒤 크기별로 PDF 나누기를 한 번 눌렀습니다. 처리가 끝나자 문서가 준비됐어요라는 문구와 sejda-KUDDDG.zip, 다운로드 버튼이 나타났습니다. 결과 이름은 ZIP 확장자였고 같은 화면에 ‘문서를 미리볼 수 없어요’라는 안내도 보였습니다. 이 안내만으로 분할 실패라고 판단하지는 않았으며, ZIP 내부 내용은 실제로 내려받은 뒤 확인해야 합니다.
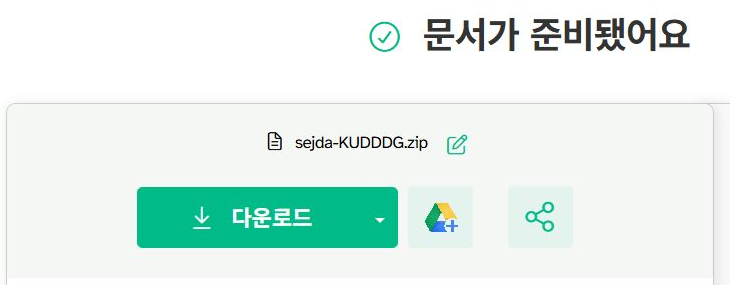
결과를 받으려면 다운로드를 눌러 ZIP을 저장한 뒤 압축을 풀어야 합니다. 현재 이 시험에서는 다운로드를 요청했지만 ZIP이 로컬에 저장됐는지 확인하지 못했습니다. 처리 완료 화면을 촬영했다는 이유로 파일 수령까지 완료했다고 쓰지 않는 이유입니다.
결과를 받는 순서는 다운로드 버튼으로 ZIP 저장 → 압축 해제 → 안에 들어 있는 PDF 열기입니다. 이번에는 ZIP 준비 화면까지 확인했으며 실제 파일 수령은 미확인이므로, 다음의 파일별 크기와 페이지 대조도 아직 수행하지 못했습니다.
모든 페이지와 파일별 크기는 어떻게 대조할까?
ZIP을 받으면 압축을 풀고 각 PDF의 실제 파일 크기를 제출처 상한과 비교하세요. 서비스 화면의 입력 숫자나 ZIP 전체 크기를 각 PDF의 크기로 대신하면 안 됩니다. MB·KB 표시 방식이 다를 수 있으므로, 가능하면 파일 속성의 바이트 값과 제출처 기준도 함께 확인하는 편이 좋습니다.
페이지는 원본 총수와 분할본 합계만 비교하고 끝내지 마세요. 각 분할본을 원본과 페이지 단위로 순서대로 대조해 빠지거나 중복된 페이지가 없는지 확인해야 합니다. 특히 첫 페이지와 마지막 페이지, 앞 파일의 끝과 다음 파일의 시작도 함께 확인하세요. 한 페이지가 빠지고 다른 페이지가 중복되면 합계만으로는 놓칠 수 있기 때문입니다. PDF 뷰어의 물리 페이지 번호와 문서 안에 인쇄된 쪽번호도 구분하세요.
이번 시험의 현재 확인 범위는 다음과 같습니다.
| 확인 항목 | 현재 확인 범위 |
|---|---|
| 원본 | 공개 NIST PDF, 48페이지·1,946,127바이트 |
| 실제 설정 | 최대 크기 500KB |
| 웹 처리 응답 | ‘문서가 준비됐어요’와 ZIP 다운로드 버튼 표시 |
| ZIP 수령·분할 PDF 개수 | 미확인 |
| 각 PDF의 실제 바이트 크기 | 미확인 |
| 48페이지의 순서·누락·중복 | 분할본 미확보로 대조 전 |
여러 파일 제출과 외부 서비스 처리가 허용된다면 Sejda 웹에서 원본을 선택하고 최대 크기·단위를 정해 분할한 뒤, ZIP을 받아 PDF별 실제 크기와 원본의 모든 페이지를 순서대로 대조하세요. 상한을 넘는 파일이 있으면 목표 크기를 낮춰 다시 나누고 확인하되, 그래도 제출 조건을 맞추지 못하면 별도 제출 방법을 협의해야 합니다. 페이지를 빼서 용량을 맞추는 방법은 아닙니다. 이번 직접 확인은 500KB 설정의 실행과 ZIP 준비 화면까지이며, 분할본의 실제 크기·48페이지의 순서·누락·중복은 아직 미확인입니다. 최종 전달 여부는 설정값이나 준비 완료 문구가 아니라 내려받은 PDF의 실제 크기와 전체 페이지 대조 결과로 판단하세요.


답글 남기기