
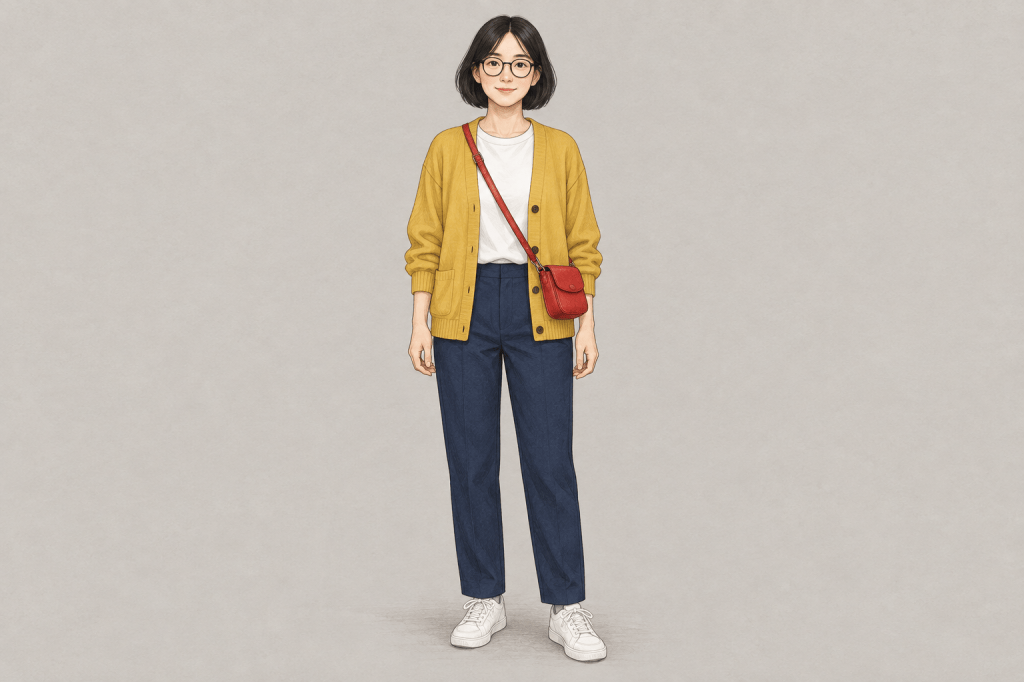
첫 그림의 인물은 마음에 드는데 다음 장면에서는 안경이나 옷이 달라진다면, ‘같은 캐릭터’라는 말만으로 충분할까요? 도서관과 공원처럼 배경이 달라져도 같은 인물로 읽히게 하려면 무엇을 남기고 무엇만 바꿀지 먼저 나눠야 합니다.
이번에는 Codex의 내장 이미지 생성 기능으로 기준 캐릭터 한 장을 만든 뒤, 그 이미지를 각각 참조해 두 장면을 생성했습니다. 아래 세 장은 실제 생성 결과입니다. ChatGPT 웹 화면이나 여러 모델을 비교한 시험은 아니며, 특정 모델의 일관성 점수를 측정하지도 않았습니다.
목차: 기준 캐릭터 정하기 · 장면별 요청하기 · 실제 결과 비교 · 다음 장면으로 이어가기
기준 캐릭터에는 무엇을 정해야 할까?
먼저 배경이 단순한 전신 이미지를 만들었습니다. 가상의 성인 여성에게 검은 단발, 둥근 검은 안경, 흰 티셔츠 위의 겨자색 카디건, 남색 바지, 흰 운동화, 빨간 크로스백을 지정했습니다. 얼굴만 아니라 장면이 바뀌어도 눈에 띄는 옷과 소품을 함께 정한 것입니다.
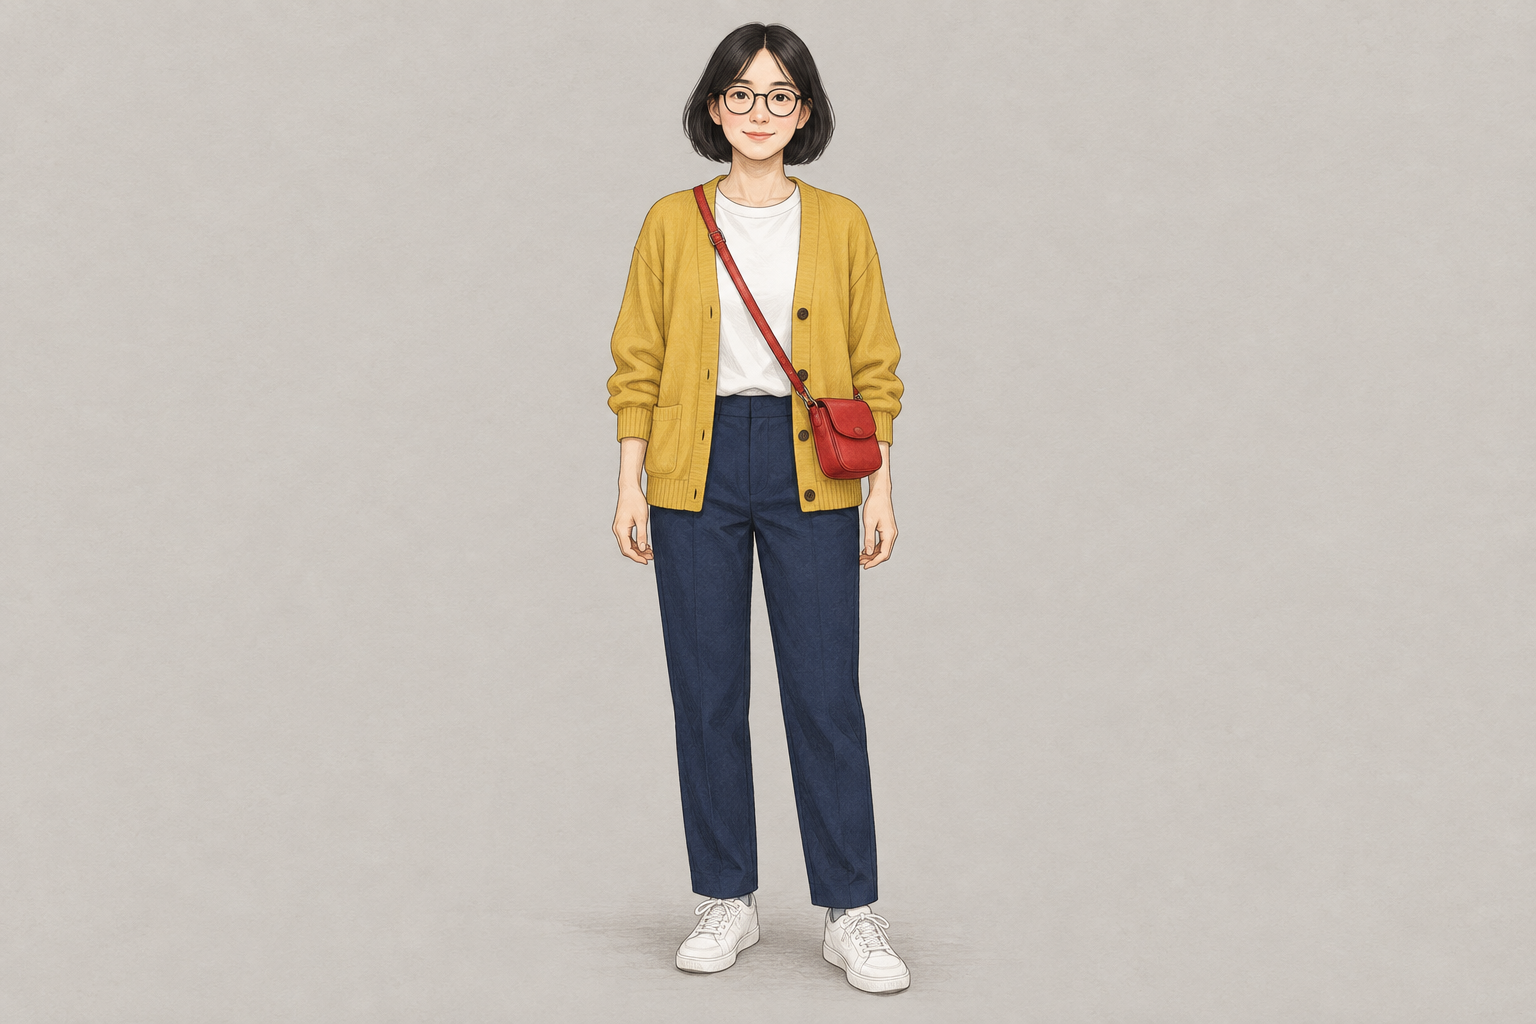
이 방식은 OpenAI의 이미지 요청 안내에서도 설명합니다. 재사용할 캐릭터 참조 이미지를 만들고, 다음 장면을 요청할 때 외형·비율·옷차림 같은 특징을 반복해 지정하는 방법입니다. 참조 이미지는 결과를 비교할 기준이지, 모든 세부를 그대로 복제한다는 보증은 아닙니다.
참조: OpenAI — 여러 장면에서 같은 캐릭터를 유지하는 요청 방법
따라서 기준 그림을 고를 때는 예쁜 얼굴 하나보다 다음 장면에서도 확인할 수 있는 얼굴·머리·옷·소품이 분명한지를 먼저 보는 편이 좋습니다. 이번 실습에서는 전신이 보이는 원본 한 장을 두 장면 모두의 공통 기준으로 삼았습니다.
도서관과 공원 장면은 어떻게 요청했을까?
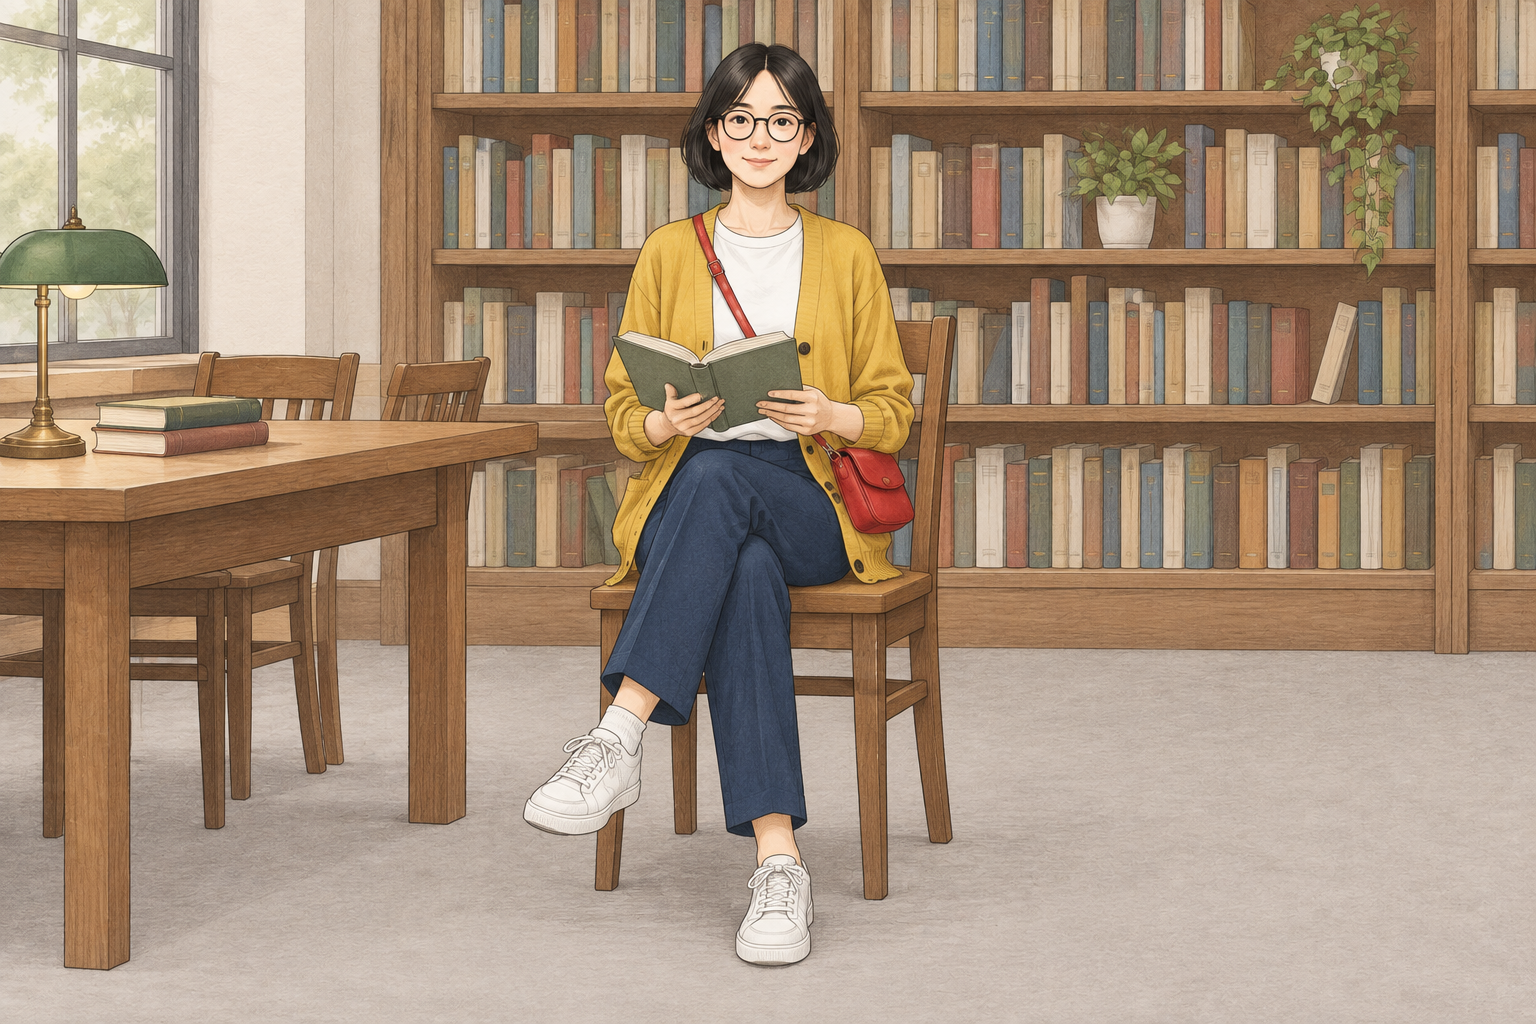
도서관 그림을 만든 다음 그 결과를 다시 바꾼 것이 아닙니다. 도서관과 공원 요청에 각각 같은 기준 이미지를 넣었습니다. 실제 실행은 영어로 요청했으며, 다음 문구는 그중 유지 조건과 장면 지시를 한국어로 옮긴 예시입니다. 두 번 모두 한 명만 나오게 하고, 같은 삽화풍·전신·가로 구도·글자 없음도 지정했습니다.
첨부 이미지를 캐릭터 기준으로 사용해 주세요. 같은 성인 여성이 조용한 도서관의 나무 의자에 앉아 펼친 책을 읽는 장면으로 바꿔 주세요. 배경과 자세만 변경하고 얼굴, 성인 체형, 검은 단발, 둥근 검은 안경, 겨자색 카디건, 흰 티셔츠, 남색 바지, 흰 운동화와 빨간 크로스백을 유지해 주세요. 가방이 보이게 해 주세요.
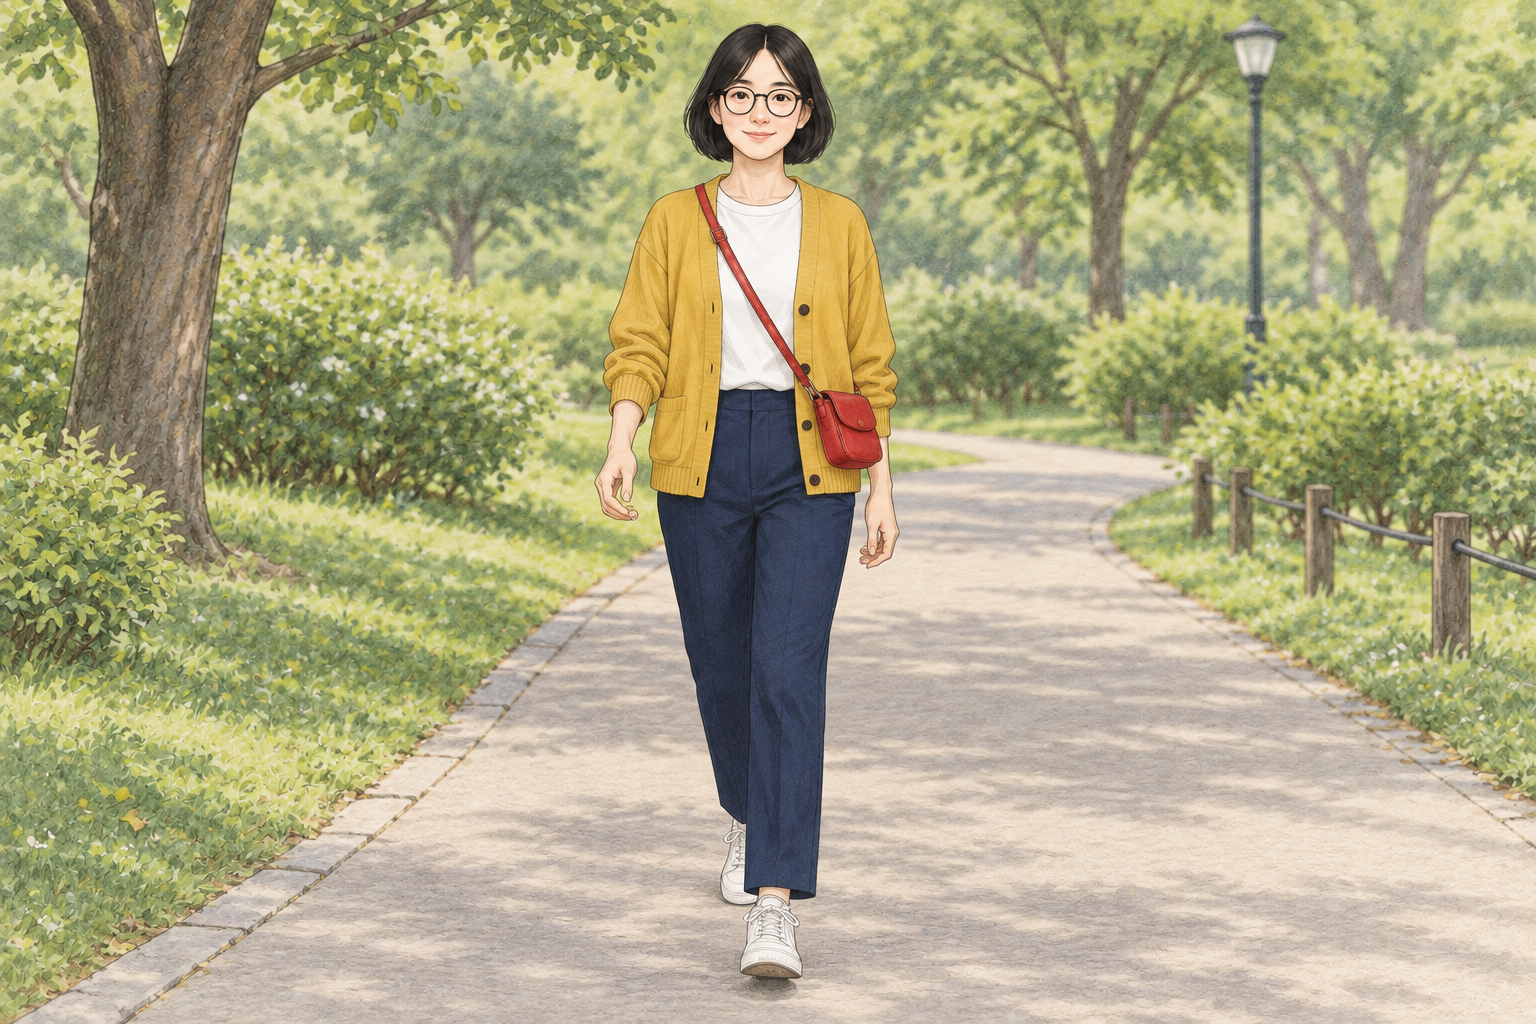
공원 요청에서는 위 문구의 장면 부분을 ‘초록빛 공원의 길을 자연스럽게 걷는 모습’으로 바꾸고, 유지할 특징은 그대로 반복했습니다. 즉 바꾸려는 부분은 장소와 동작이고, 유지하려는 부분은 인물을 알아보게 하는 특징입니다.
장면 요청은 같은 원본을 다시 첨부하고, 새 배경·동작과 유지할 외형을 나눠 적는 방식으로 구성할 수 있습니다. ‘아까 그 사람’이라고만 쓰는 것보다 어떤 조건을 다음 그림에서 비교해야 하는지도 분명해집니다.
실제 결과에서는 무엇이 유지되고 무엇이 달라졌을까?
세 장을 나란히 보면 검은 단발과 둥근 안경, 카디건·바지·신발의 색, 빨간 가방이 모두 보입니다. 제 시각적 판단으로는 같은 캐릭터를 이어 그린 결과로 읽힙니다. 다만 얼굴을 수치로 비교한 것이 아니므로 ‘동일 인물 정확도 100%’ 같은 평가로 바꿀 수는 없습니다.
장면 지시는 별도로 확인해야 합니다. 도서관 결과는 의자와 책장을 갖추고 펼친 책을 들었지만, 시선은 책보다 정면을 향합니다. ‘책을 읽는 모습’이라는 요청을 세부 동작까지 그대로 충족했다고 보기는 어렵습니다. 공원에서는 걷는 자세가 나왔지만 옷의 주름과 세부 선이 기준 그림과 픽셀 단위로 같지는 않습니다.
이번 비교에서 확인한 것은 주요 외형 특징을 유지한 두 장면이지, 모든 세부 지시가 완벽하게 지켜진 결과가 아닙니다. 캐릭터의 연속성과 장면의 정확성은 따로 확인해야 한다는 점이 특히 도서관의 시선에서 드러났습니다.
다음 장면까지 이어 만들 때 무엇을 남겨야 할까?
다음 그림을 요청할 때도 기준 원본과 고정 특징 목록을 함께 사용하면 비교 기준이 흔들리지 않습니다. 결과가 마음에 들지 않는 부분은 한 번에 여러 조건을 바꾸기보다 ‘책을 내려다보도록 시선만 수정하고 얼굴·옷·구도는 유지’처럼 범위를 좁혀 요청할 수 있습니다. 이 문구는 다음 작업을 위한 제안이며, 이번 실습에서 추가 수정 결과까지 확인한 것은 아닙니다.
참조: OpenAI — 이미지를 단계별로 수정하고 변경 범위를 좁히는 방법
같은 캐릭터로 여러 장면을 만들려면 기준 이미지 한 장, 유지할 외형 목록, 장면마다 바꿀 배경과 동작을 함께 전달하는 데서 시작하면 됩니다. 이번에는 도서관과 공원에서 주요 특징이 이어졌지만 도서관의 시선은 요청과 달랐습니다. 결과를 고를 때도 ‘같은 인물로 보이는가’와 ‘요청한 행동을 하는가’를 나눠 비교해야 연속 장면으로 쓸 수 있는지를 판단할 수 있습니다.


답글 남기기